Casi d'uso di Data Store: come supporta le esigenze di tracciamento
Scritto da
Mykhailo Zernov
Data Store è un database NoSQL integrato per gli utenti di Google Tag Manager lato server. È veloce, affidabile e facile da usare: consente di memorizzare e recuperare qualsiasi tipo di dati JSON senza configurare un database esterno.
Sebbene sia stato inizialmente creato per semplificare la gestione dei dati all'interno dei contenitori server, le aziende applicano Data Store in molti modi creativi. Per scoprire tutto su questa funzionalità, sulle sue capacità e su come sfruttarla al meglio, consulti la nostra guida dettagliata su Data Store. In questo articolo, invece, esaminiamo alcuni dei modi più comuni e interessanti per utilizzare Data Store e come trarne vantaggio.
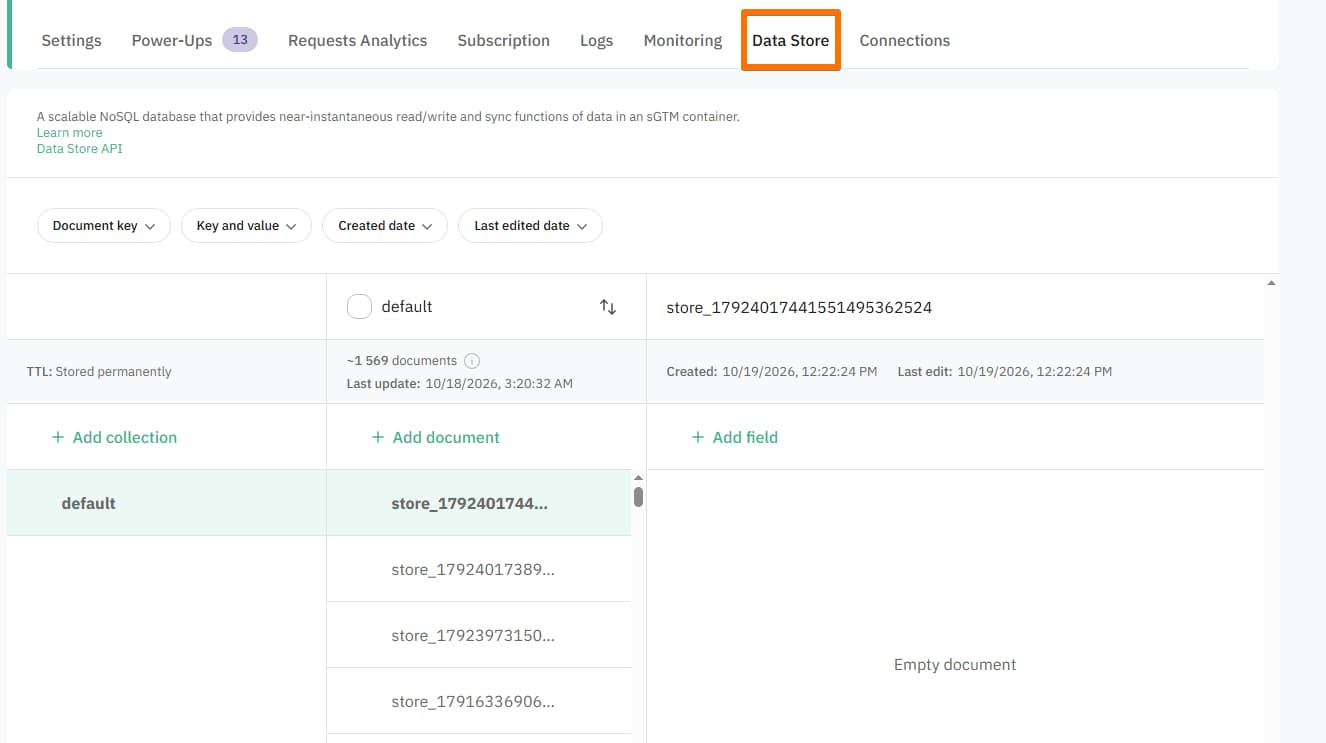
1. Utilizzare Data Store al posto di Firestore
Molti utenti scelgono Data Store come alternativa a Firestore. Lo utilizzano per memorizzare qualsiasi dato, dalle informazioni sui clienti alla cronologia degli acquisti (ad esempio, salvando tutti i prodotti acquistati dai propri clienti). Possono esserci diversi motivi per farlo: ad esempio, Data Store è integrato direttamente nella piattaforma Stape, quindi non è necessaria alcuna configurazione esterna. È possibile iniziare a salvare e leggere i dati immediatamente all'interno del proprio contenitore sGTM, senza lasciare l'account Stape.
Alcuni utenti acquistano persino l'abbonamento a Stape senza utilizzare power-up, Server GTM Hosting o altri servizi all'infuori di Store. Per loro, la sola funzionalità Store offre un valore sufficiente a giustificare il costo!
Il vantaggio principale è un'architettura più semplice: invece di effettuare il provisioning di un altro database, gestire credenziali e mantenere un'integrazione aggiuntiva, i team possono utilizzare un livello di archiviazione già incluso nella loro configurazione sGTM ospitata su Stape.
2. Controllo delle transazioni duplicate
Un altro caso d'uso diffuso è il rilevamento delle transazioni duplicate. Le conversioni duplicate possono gonfiare le statistiche e causare un'attribuzione errata su piattaforme come Google Ads o Google Analytics. Memorizzando gli ID di transazione in Data Store, è possibile verificare facilmente se una conversione è già stata elaborata. Questa configurazione è particolarmente utile per il tracciamento lato server con conversioni caricate tramite API.
Lo stesso approccio può essere utilizzato per qualsiasi processo che richieda la deduplicazione. Ciò include ID evento, ID ordine, ID lead, ID webhook o altri identificatori aziendali univoci.
Perché è utile:
- Metriche accurate: ogni transazione viene conteggiata una sola volta.
- Migliore attribuzione: impedisce che il merito venga assegnato erroneamente a più canali.
- Gestione più intelligente del budget: aiuta ad allocare i budget pubblicitari basandosi su dati puliti e affidabili.
3. Arricchimento dei webhook con i dati archiviati
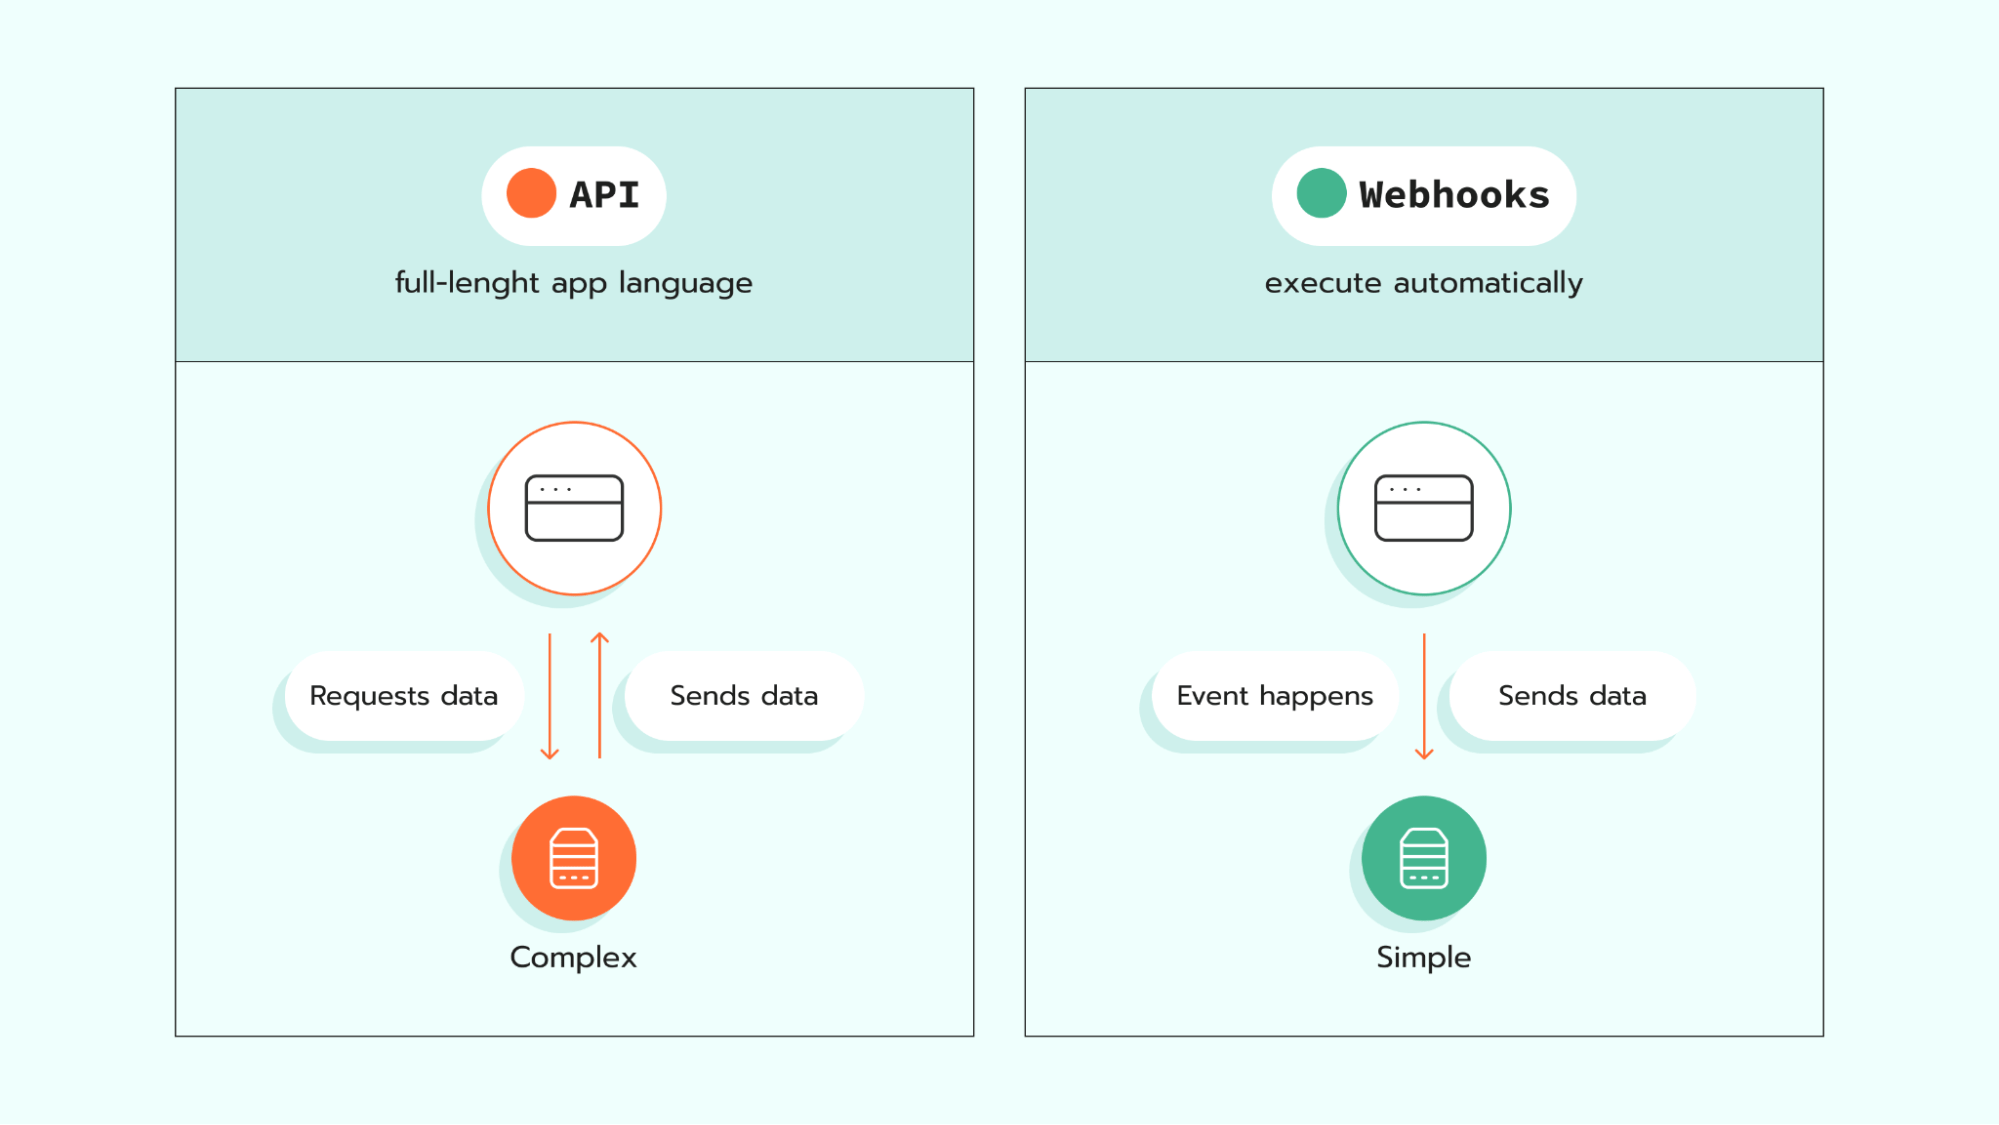
I webhook automatizzano il trasferimento di dati tra applicazioni web in tempo reale. Alcuni dei nostri clienti utilizzano Data Store per aggiungere dati supplementari ai webhook. Questo approccio garantisce che gli eventi di tracciamento includano sempre il contesto completo. Funziona così:
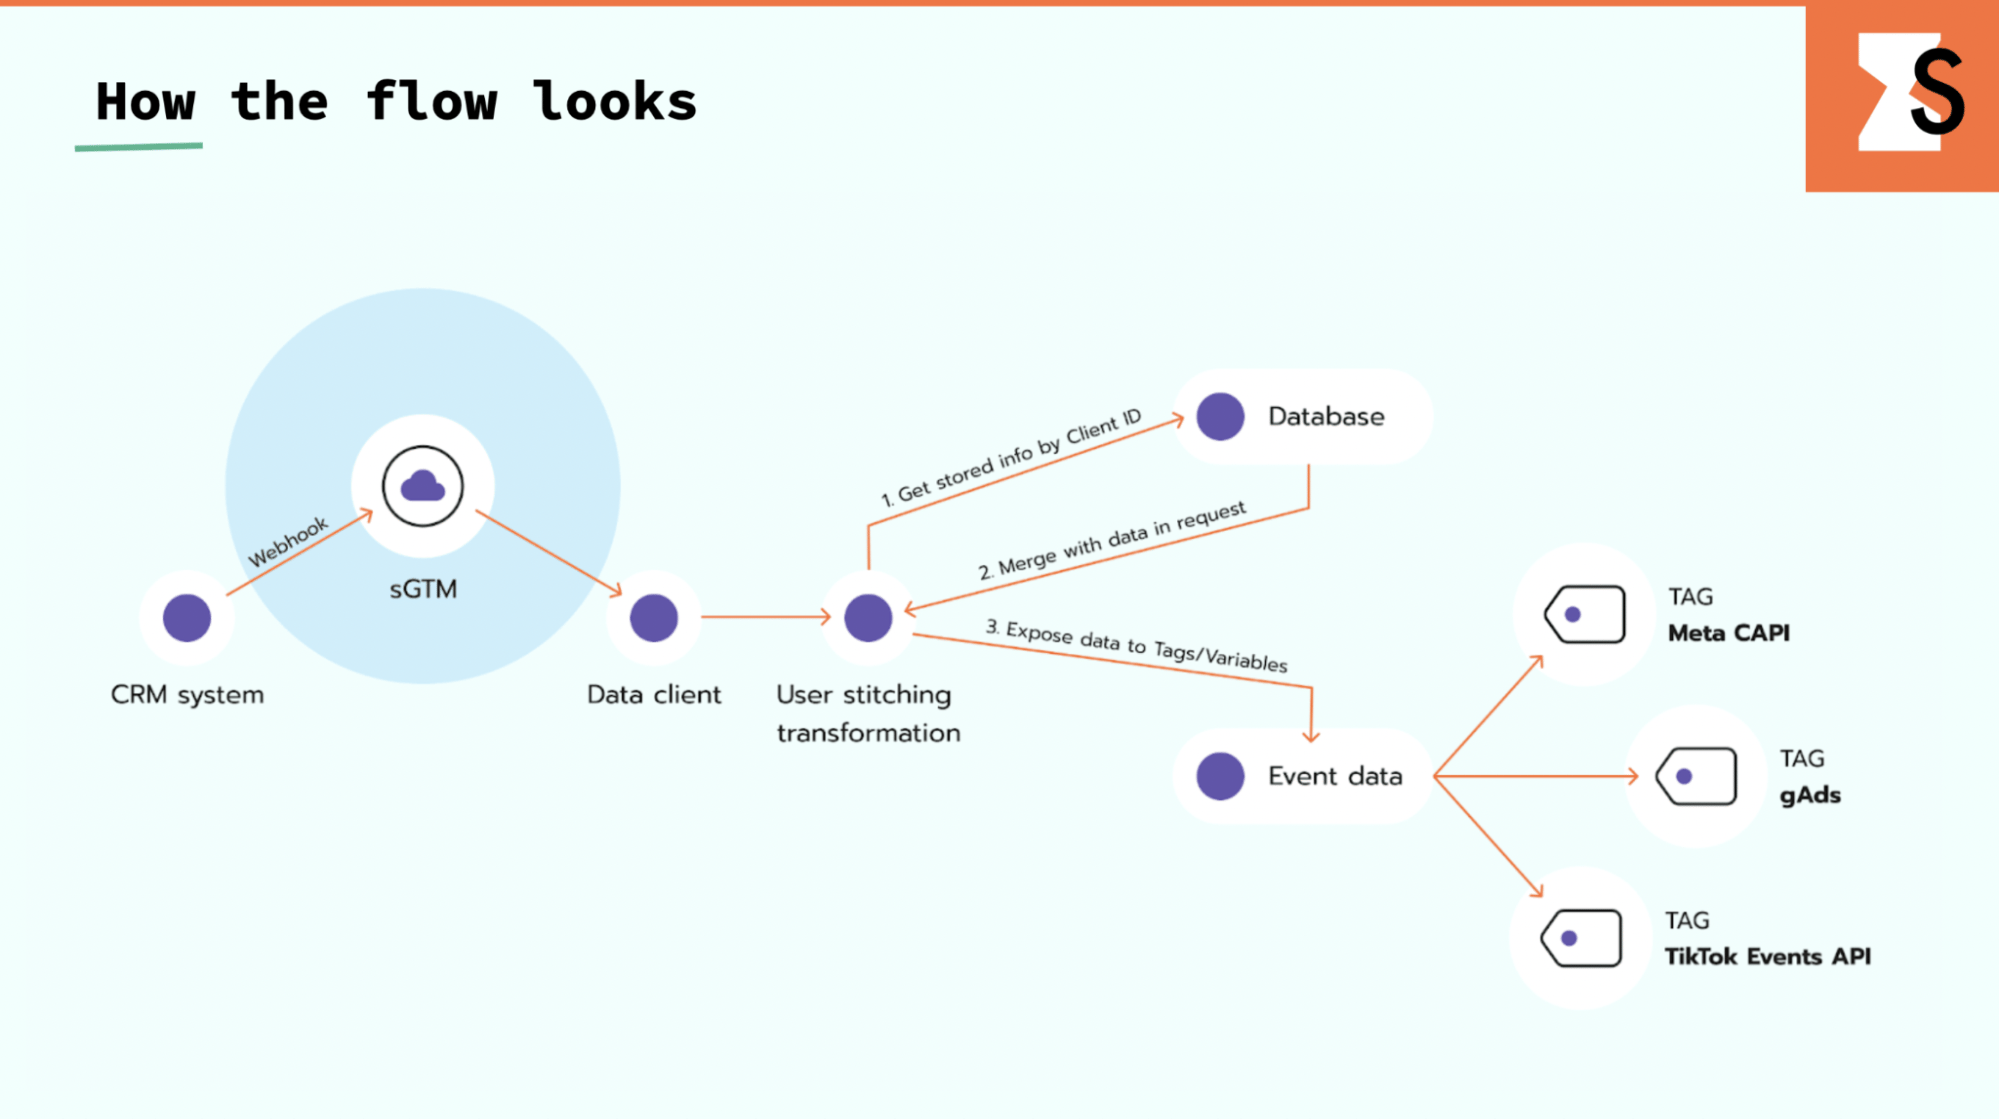
- 1.Quando un utente compie un'azione online (ad es. l'invio di un modulo), si salvano i relativi cookie o identificatori nello Store sotto una chiave come il suo indirizzo email.
- 2.In seguito, quando arriva un evento webhook, si cerca la stessa chiave nello Store, si recuperano i dati dell'utente e si invia un set di dati completo, inclusi cookie e identificatori, a piattaforme come Google Ads o Meta Conversions API.
Il power-up Enricher di Stape consente già di arricchire i dati degli eventi con i dati utente raccolti in precedenza. Tuttavia, se combinato con Data Store, permette anche di arricchire gli eventi con dati provenienti esclusivamente dal backend.
Un altro impiego di Data Store per l'arricchimento dei dati consiste nell'aggiungere informazioni che non dovrebbero o non possono essere esposte nel browser, come lo stato nel CRM, il livello del cliente, le classificazioni interne dei prodotti, lo stato delle scorte, la titolarità dell'account, i dati sui margini o gli esiti dell'evasione dell'ordine. L'evento arricchito inviato alle piattaforme di analisi o pubblicitarie trasmette un contesto aziendale che il solo tracciamento lato client non può fornire.
Caso studio: CPA inferiore del 14,3% e "ROAS fantasma" eliminato per un gruppo di boutique hotel di lusso | Stape Care
- Sfida: le lacune del tracciamento lato client, unite a cancellazioni offline non tracciate, generavano cifre di ROAS gonfiate e spingevano Smart Bidding a ottimizzare verso conversioni fantasma.
- Soluzione: migrazione lato server tramite Custom Loader e Cookie Keeper, abbinati a webhook PMS e Google Ads Conversion Adjustments (
RETRACTION/RESTATEMENT) instradati tramite Data Store. - Risultati: aumento del 17,1% nella copertura del tracciamento, storno automatico del 13% delle cancellazioni, True CPA ridotto del 14,3%.
Per saperne di più: https://stape.io/blog/google-ads-hotel-revenue-alignment-case-study
4. Tracciamento multidominio
Il tracciamento multidominio spesso si interrompe poiché i cookie non possono essere condivisi tra domini diversi.
Con Data Store è possibile salvare cookie o identificatori sotto una chiave condivisa (ad esempio un User ID) e poi ripristinarli quando lo stesso utente approda su un altro dominio. In questo modo, i dati utente rimangono coerenti e le piattaforme di analisi possono attribuire con precisione le conversioni anche tra siti web diversi.
Come funziona in pratica:
- 1.Quando un utente visita il primo dominio, i dati di tracciamento chiave (cookie, ID di sessione, identificatori utente) vengono memorizzati in Data Store.
- 2.Quando lo stesso utente prosegue il proprio percorso su un altro dominio, il sistema recupera i dati archiviati da Data Store utilizzando l'identificatore condiviso.
- 3.Questi dati ripristinati aiutano a preservare il collegamento tra visite e conversioni, garantendo che le piattaforme di analisi e pubblicitarie riconoscano che si tratta dello stesso utente.
Lo stesso modello può estendersi oltre i siti web. È possibile preservare il contesto di attribuzione quando un cliente passa da un sito web a un CRM, un call center o un altro processo offline, recuperando poi gli identificatori pertinenti all'arrivo di un evento di backend o di un webhook.
5. Tracciamento del Profit Over Ad Spend (POAS)
La maggior parte degli inserzionisti misura il rendimento tramite il ROAS (Return on Ad Spend), ma il ROAS non include i costi dei prodotti. Il Profit Over Ad Spend (POAS) è una metrica più precisa, poiché si concentra sul profitto effettivo e non solo sulle entrate.
Stape offre già un power-up dedicato, POAS Data Feed, che consente di memorizzare e recuperare in modo sicuro i dati sui profitti e utilizzarli al posto delle entrate nella generazione di report sulle conversioni per Google Ads o Analytics. Tuttavia, Data Store potenzia questa funzionalità per consentire calcoli POAS più avanzati.
Ad esempio, il profitto può dipendere da SKU, mercato, sconti, spese di spedizione, commissioni di pagamento, provvigioni, resi o segmenti di clientela. Questi parametri possono essere memorizzati lato server e utilizzati per calcolare un valore di profitto più accurato prima di inviare i dati di conversione alle piattaforme di analisi o pubblicitarie.
- Eseguire offerte basate sul profitto mantenendo riservati i dati finanziari sensibili.
- Caricare le conversioni in tempo reale senza esporre i dati interni.
- Ottenere un quadro più realistico di quali annunci generano realmente profitto, non solo vendite.
6. Persistenza dei Click ID oltre i cookie del browser
I Click ID vengono comunemente memorizzati nei cookie del browser, ma i cookie possono scadere, essere bloccati, non risultare accessibili ai sistemi di backend o non riuscire a trasferire i dati di attribuzione a una conversione successiva. Data Store offre un luogo alternativo per rendere persistenti questi identificatori.
Ad esempio, è possibile memorizzare un click ID associandolo a una chiave stabile come un User ID, un ID di sessione, un ID lead o un ID ordine. Quando in seguito si verifica una conversione, il click ID può essere recuperato tramite tale chiave e aggiunto all'evento di conversione. Questo approccio richiede comunque un identificatore stabile che colleghi il clic originale all'evento successivo, ma consente ai dati di attribuzione di sopravvivere anche quando l'archiviazione nel browser non è più disponibile.
7. Archiviazione generale dei dati
Infine, Data Store è utile in quasi tutti i casi in cui sia necessario memorizzare dati a breve o a lungo termine per poi riutilizzarli in seguito. È più affidabile e scalabile rispetto ai cookie o al local storage. Tutto ciò che serve è una chiave per scrivere e recuperare i dati, come l'email dell'utente, un ID o un token di sessione.
- Creare documenti e raccolte per contenere più file.
- Cercare e filtrare utilizzando condizioni.
- Impostare un TTL (time-to-live) affinché i documenti scadano automaticamente quando non sono più necessari.
- Recuperare e utilizzare i dati archiviati nello store per arricchire i flussi di eventi di GTM lato server (ad es. per attributi utente, parametri personalizzati, token).
- Utilizzare le API per accedere allo store a livello programmatico tramite endpoint.
8. Tabelle di ricerca dinamiche e regole di instradamento
Le tabelle di ricerca standard di GTM possono diventare difficili da gestire quando le mappature sono ampie, aggiornate di frequente o sensibili dal punto di vista operativo. Data Store può conservare questi set di dati al loro posto.
Ad esempio, è possibile memorizzare regole di prodotto, classificazioni delle campagne, impostazioni regionali, mappature dei tenant o altri valori di configurazione. È quindi possibile aggiornarli tramite la dashboard di Stape, l'importazione di CSV o le API senza dover ripubblicare il contenitore sGTM a ogni modifica di un valore.
Lo stesso approccio può essere utilizzato per selezionare dinamicamente destinazioni, account, endpoint o credenziali in base a fattori quali brand, regione, tenant, commerciante, tipo di evento o stato del consenso.
9. Collegamento di visitatori anonimi con clienti noti
Data Store può contribuire a collegare l'attività anonima di un utente con la sua identità e con le azioni precedenti non appena viene identificato. Ciò rende anche più affidabile il tracciamento dei clienti nuovi e di ritorno.
Ad esempio, un visitatore potrebbe navigare sul sito web prima di effettuare l'accesso o inviare un modulo. È possibile memorizzare la relazione tra il relativo identificatore anonimo di browser o di sessione e l'identificatore del cliente. Quando l'utente diventa noto, gli eventi futuri possono utilizzare tale associazione per recuperare gli attributi di identità approvati e mantenere la continuità tra le sessioni precedentemente anonime.
10. Applicazione degli stati di consenso agli eventi di backend
Le informazioni sul consenso sono spesso disponibili nel browser ma mancanti quando un evento proviene da un CRM, un webhook, un sistema offline o un'altra sorgente di backend. Data Store può conservare lo stato di consenso dell'utente insieme a metadati come la sorgente, il timestamp o la versione dell'informativa.
Quando in seguito giunge un evento di backend, lo stato di consenso archiviato può essere recuperato prima di stabilire quali destinazioni e parametri siano consentiti. Ciò contribuisce ad applicare regole di consenso coerenti anche agli eventi non provenienti dal browser.
11. Acquisizione dei dati di richiesta per il debug mirato
In alcuni casi, i log standard non conservano il payload della richiesta o i campi specifici necessari per analizzare un problema di tracciamento. Data Store può trattenere temporaneamente i dati di richiesta selezionati in una raccolta dedicata per il debug.
Questo approccio va utilizzato con cautela: è opportuno applicare attivatori specifici, TTL brevi, minimizzazione dei dati e filtro delle PII. Memorizzare ogni richiesta può creare rischi inutili per la privacy ed esaurire rapidamente i limiti di scrittura del database.
Conclusione
Data Store si è evoluto da una semplice funzionalità a uno strumento potente che supporta un'ampia gamma di casi d'uso di tracciamento e gestione dati. Con esso è possibile configurare il tracciamento multidominio, risolvere le transazioni duplicate, creare una CDP leggera o semplicemente archiviare dati per un utilizzo futuro.
Poiché è integrato direttamente nella piattaforma Stape, non è necessario configurare né mantenere un database esterno. È possibile iniziare a salvare e recuperare dati direttamente all'interno del proprio contenitore GTM server. Data Store può sostituire strumenti come Firestore mantenendo tutto sotto lo stesso tetto.
Desidera iniziare con il lato server?
Provare gratuitamente
Commenti