Casos de uso de Data Store: cómo respalda sus necesidades de seguimiento
Escrito por
Mykhailo Zernov
Data Store es una base de datos NoSQL integrada para usuarios de Google Tag Manager del lado del servidor. Es rápida, confiable y fácil de usar: puede almacenar y recuperar cualquier tipo de datos JSON sin configurar una base de datos externa.
Aunque originalmente se diseñó para simplificar la gestión de datos dentro de los contenedores del servidor, las empresas aplican Data Store de muchas formas creativas. Para conocer todo sobre esta función, sus capacidades y cómo aprovecharla al máximo, consulte nuestra guía detallada sobre Data Store. En este artículo, analizaremos algunas de las formas más comunes e interesantes de utilizar Data Store y cómo usted también puede beneficiarse de ella.
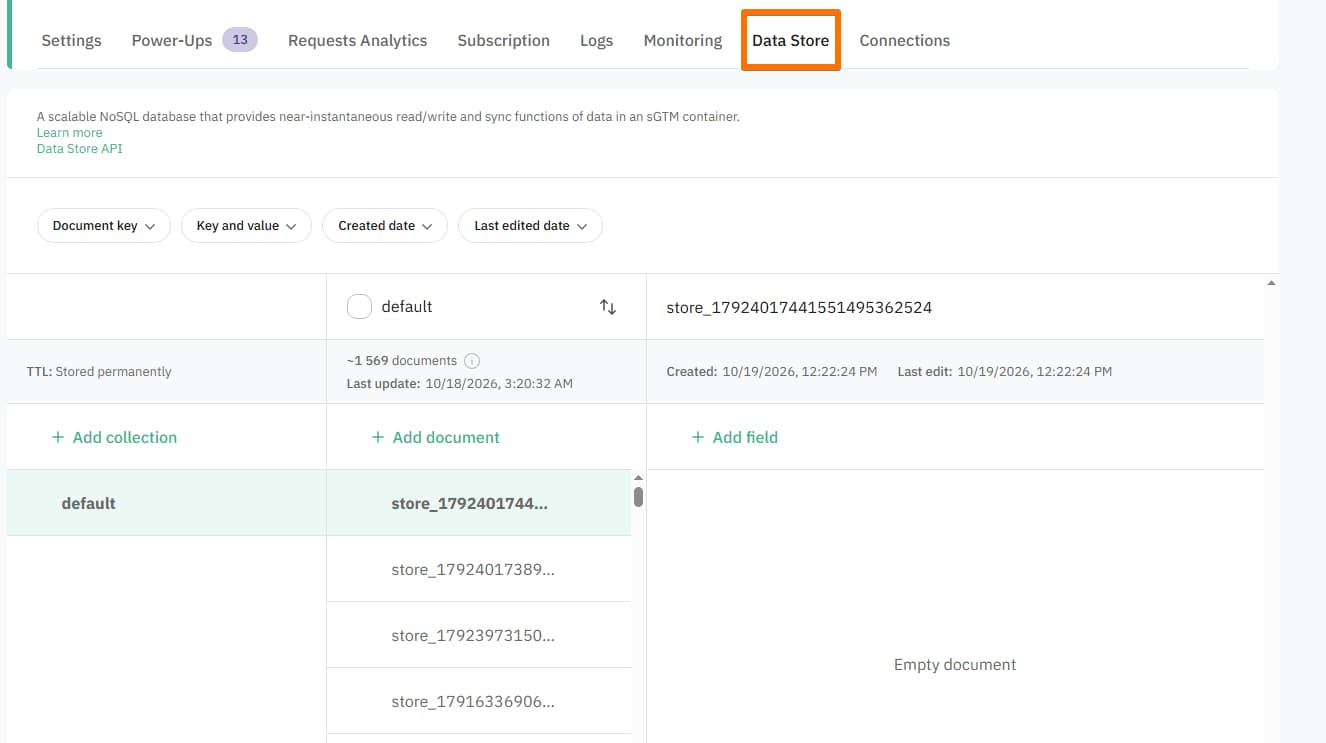
1. Uso de Data Store en lugar de Firestore
Muchos usuarios eligen Data Store como alternativa a Firestore. La utilizan para almacenar desde datos de clientes hasta historiales de compras (por ejemplo, guardando todos los productos que han comprado sus clientes). Puede haber distintas razones para hacerlo; por ejemplo, Data Store está integrada directamente en la plataforma de Stape, por lo que no es necesaria ninguna configuración externa. Puede comenzar a guardar y leer datos de inmediato dentro de su contenedor de sGTM, sin salir de su cuenta de Stape.
Algunos usuarios incluso adquieren la suscripción de Stape y no utilizan power-ups, alojamiento de sGTM ni ningún otro servicio que no sea Store. Para ellos, ¡la función Store por sí sola es lo suficientemente valiosa como para justificar el costo!
La principal ventaja es una arquitectura más simple: en lugar de aprovisionar otra base de datos, gestionar credenciales y mantener una integración adicional, los equipos pueden utilizar una capa de almacenamiento que ya forma parte de su configuración de sGTM alojada en Stape.
2. Verificador de transacciones duplicadas
Otro caso de uso popular es la detección de transacciones duplicadas. Las conversiones duplicadas pueden inflar sus analíticas y provocar una atribución errónea en plataformas como Google Ads o Google Analytics. Al almacenar los ID de transacción en Data Store, usted puede verificar fácilmente si una conversión ya ha sido procesada. Esta configuración es muy práctica para el seguimiento del lado del servidor con conversiones subidas mediante API.
El mismo enfoque puede utilizarse para cualquier proceso que requiera deduplicación. Esto incluye ID de eventos, ID de pedidos, ID de clientes potenciales, ID de webhooks u otros identificadores comerciales únicos.
Por qué es útil:
- Métricas precisas: cada transacción se cuenta solo una vez.
- Mejor atribución: evita que se asigne un crédito erróneo a múltiples canales.
- Presupuestación más inteligente: ayuda a asignar los presupuestos publicitarios basándose en datos limpios y fiables.
3. Enriquecimiento de webhooks con datos almacenados
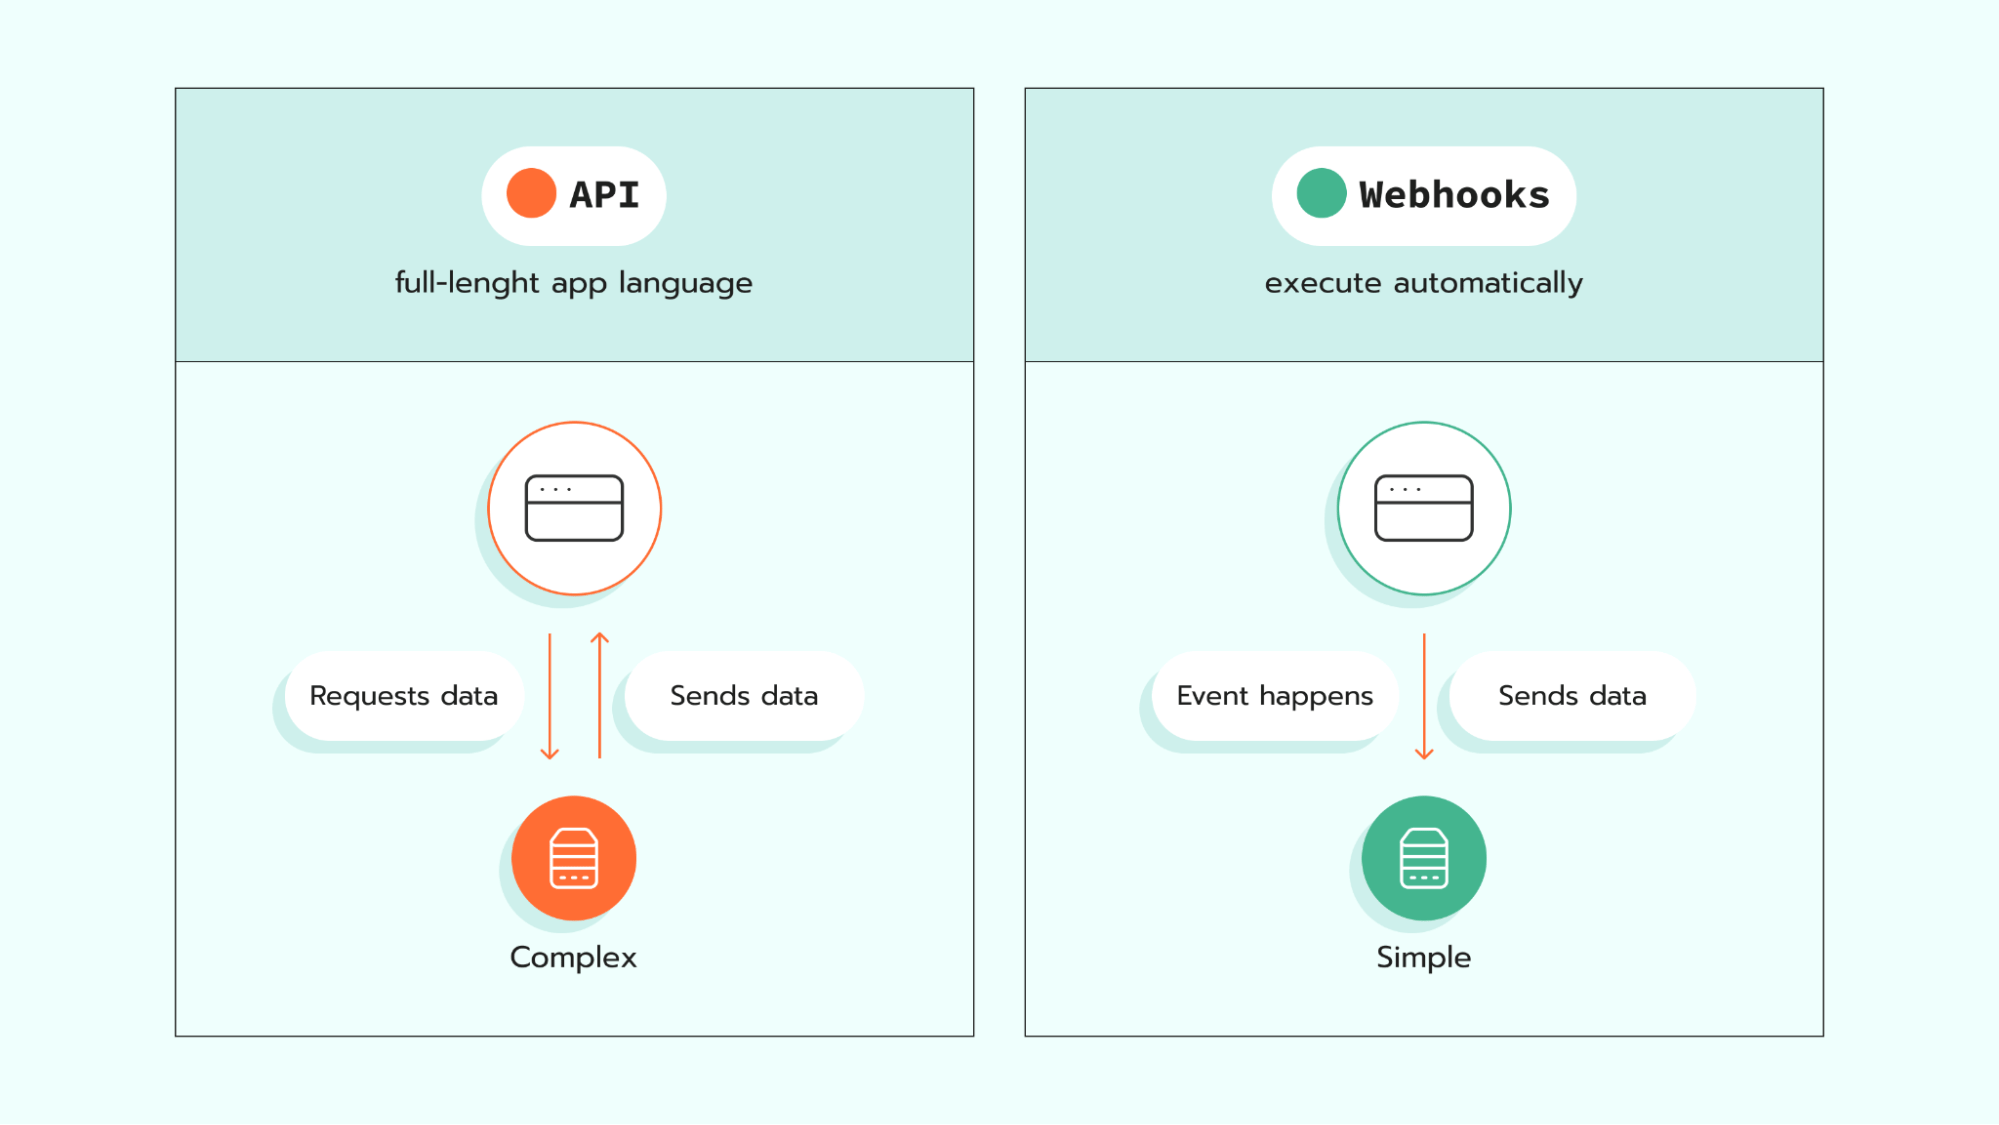
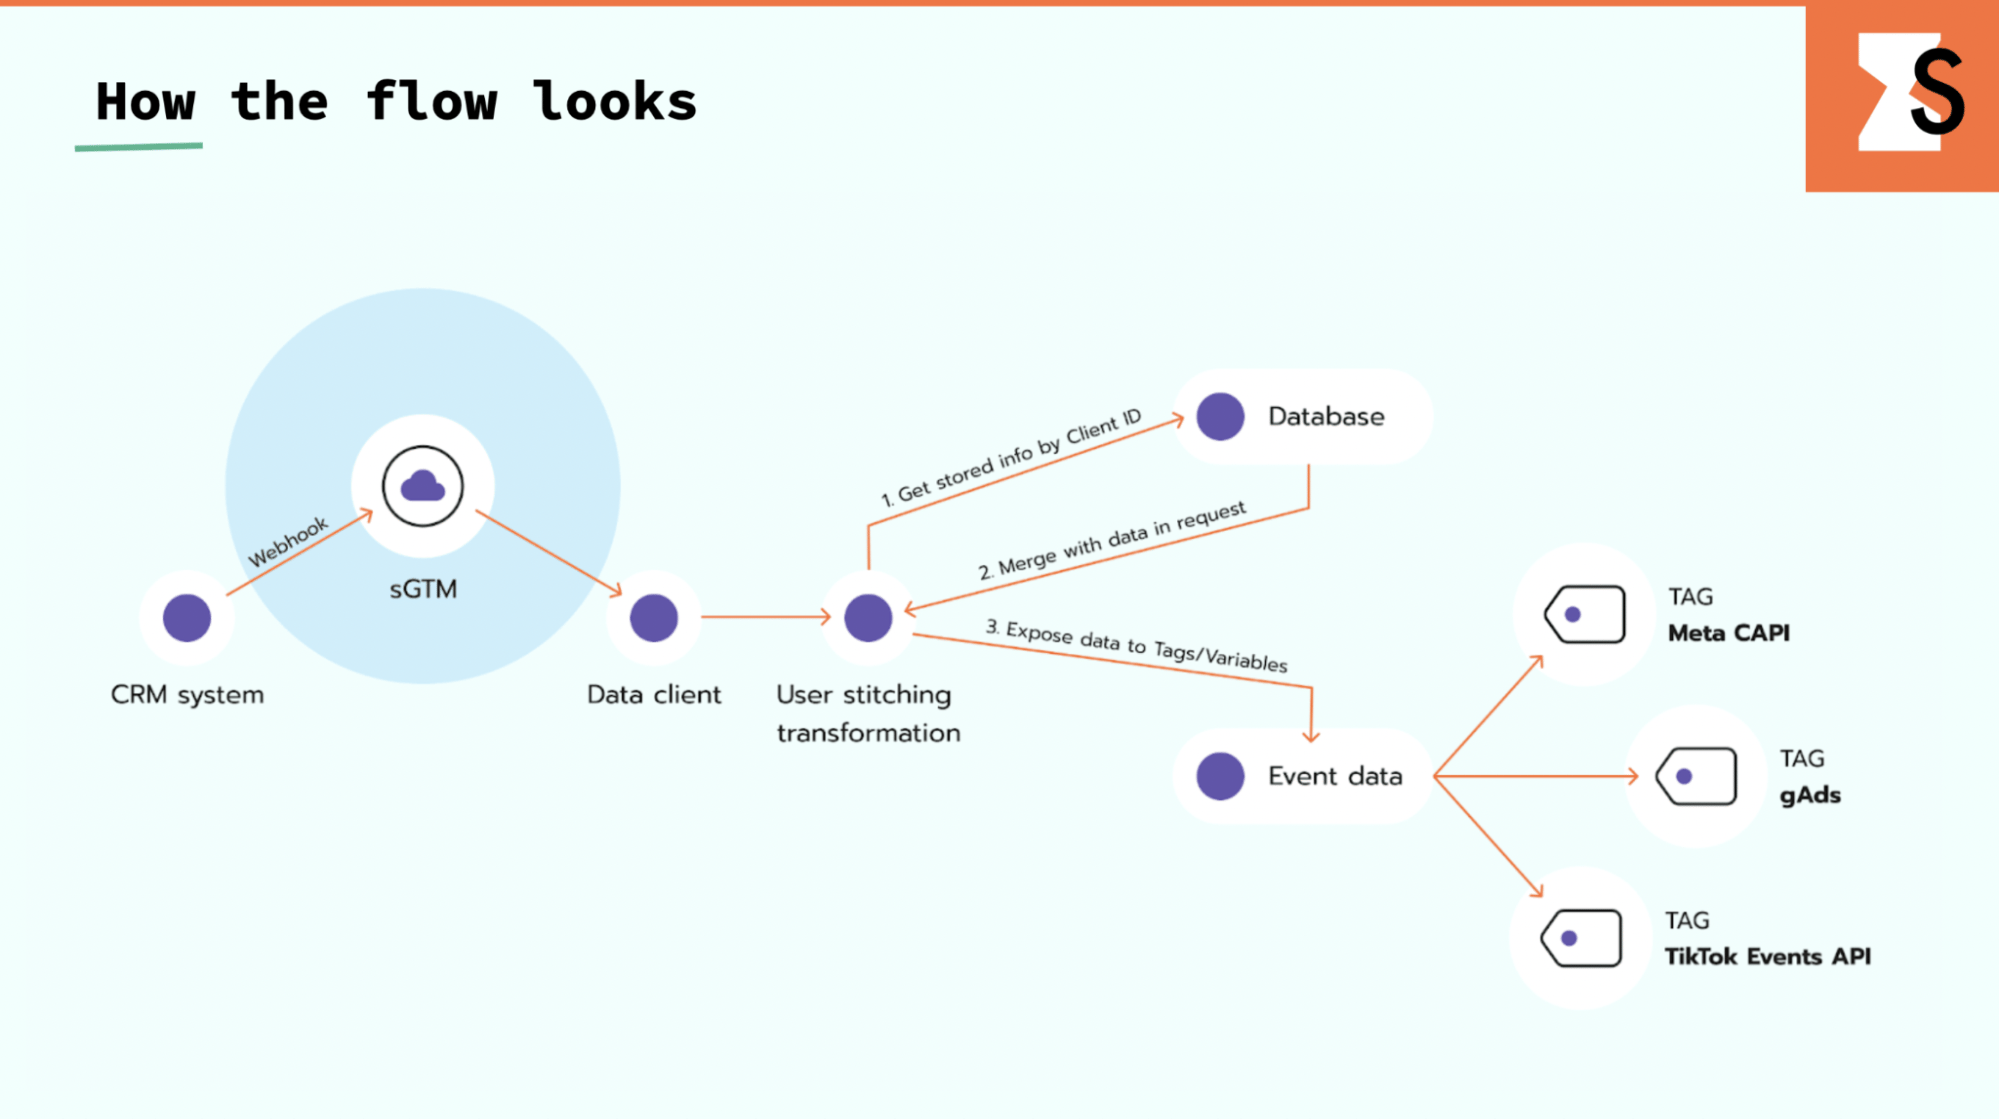
Los webhooks automatizan la transferencia de datos entre aplicaciones web en tiempo real. Algunos de nuestros clientes utilizan Data Store para añadir datos adicionales a los webhooks. Este enfoque garantiza que sus eventos de seguimiento incluyan siempre el contexto completo. Funciona así:
- 1.Cuando un usuario realiza una acción en línea (por ejemplo, el envío de un formulario), usted guarda sus cookies o identificadores en Store bajo una clave como su correo electrónico.
- 2.Más adelante, cuando se recibe un evento de webhook, usted busca la misma clave en Store, recupera los datos del usuario y envía un conjunto de datos completo, incluidas cookies e identificadores, a plataformas como Google Ads o Meta Conversions API.
El power-up Enricher de Stape ya le permite enriquecer los datos de eventos con datos de usuarios recopilados previamente. Sin embargo, al combinarlo con Data Store, también puede enriquecer eventos con datos exclusivos del backend.
Otro uso de Data Store para el enriquecimiento de datos es añadir información que no debe o no puede exponerse en el navegador, como el estado en el CRM, el nivel del cliente, las clasificaciones internas de productos, el estado del inventario, la titularidad de la cuenta, los datos de margen o los resultados de cumplimiento. El evento enriquecido que se envía a las plataformas publicitarias o de analítica aporta un contexto comercial que el seguimiento del lado del cliente por sí solo no puede proporcionar.
Caso de estudio: reducción del 14,3 % en el CPA y eliminación del "ROAS fantasma" para un grupo de hoteles boutique de lujo | Stape Care
- Desafío: las brechas en el seguimiento del lado del cliente, combinadas con cancelaciones offline no registradas, produjeron cifras de ROAS infladas e impulsaron a Smart Bidding a optimizar hacia conversiones fantasma.
- Solución: migración del lado del servidor mediante Custom Loader y Cookie Keeper, combinada con webhooks del PMS y Google Ads Conversion Adjustments (
RETRACTION/RESTATEMENT) enrutados a través de Data Store. - Resultados: aumento del 17,1 % en la cobertura de seguimiento, retracción del 13 % en cancelaciones aplicada automáticamente, reducción del 14,3 % en el True CPA.
Más información: https://stape.io/blog/google-ads-hotel-revenue-alignment-case-study
4. Seguimiento multidominio
El seguimiento multidominio a menudo falla porque las cookies no se pueden compartir entre dominios.
Con Data Store, usted puede guardar cookies o identificadores bajo una clave compartida (por ejemplo, un ID de usuario) y luego restaurarlos cuando el mismo usuario llegue a otro dominio. De este modo, los datos de sus usuarios se mantienen coherentes y sus analíticas pueden atribuir con precisión las conversiones, incluso entre diferentes sitios web.
Cómo funciona en la práctica:
- 1.Cuando un usuario visita su primer dominio, usted almacena datos clave de seguimiento (cookies, ID de sesión, identificadores de usuario) en Data Store.
- 2.Cuando el mismo usuario continúa su navegación en otro dominio, el sistema recupera los datos almacenados de Data Store utilizando el identificador compartido.
- 3.Estos datos restaurados ayudan a conservar la conexión entre las visitas y las conversiones, lo que garantiza que sus plataformas publicitarias y de analítica reconozcan que se trata del mismo usuario.
El mismo patrón puede extenderse más allá de los sitios web. Puede preservar el contexto de atribución cuando un cliente pasa de un sitio web a un CRM, un centro de llamadas u otro proceso offline, y luego recuperar los identificadores pertinentes cuando llega un evento de backend o un webhook.
5. Seguimiento del Profit Over Ad Spend (POAS)
La mayoría de los anunciantes miden el rendimiento mediante el ROAS (Return on Ad Spend), pero el ROAS no incluye los costos de los productos. Profit Over Ad Spend (POAS) es una métrica más precisa. Se centra en el beneficio real, no solo en los ingresos.
Stape ya cuenta con un power-up dedicado, POAS Data Feed, que le permite almacenar y recuperar datos de beneficios de forma segura y utilizarlos en lugar de los ingresos al registrar conversiones en Google Ads o Analytics. Sin embargo, Data Store amplía esta funcionalidad para permitir cálculos de POAS más avanzados.
Por ejemplo, el beneficio puede depender del SKU, el mercado, los descuentos, los costos de envío, las comisiones de pago, las devoluciones o los segmentos de clientes. Estas variables se pueden almacenar del lado del servidor y utilizarse para calcular un valor de beneficio más preciso antes de enviar los datos de conversión a sus plataformas publicitarias o de analítica.
- Ejecute pujas basadas en beneficios manteniendo la privacidad de los datos financieros confidenciales.
- Suba conversiones en tiempo real sin exponer cifras internas.
- Obtenga una imagen más realista de qué anuncios generan realmente beneficios, no solo ventas.
6. Persistencia de los ID de clic más allá de las cookies del navegador
Los ID de clic se suelen almacenar en las cookies del navegador, pero estas pueden caducar, bloquearse, quedar inaccesibles para los sistemas de backend o no transmitir los datos de atribución a una conversión posterior. Data Store ofrece otro espacio para conservar estos identificadores.
Por ejemplo, puede almacenar un ID de clic vinculado a una clave estable como un ID de usuario, ID de sesión, ID de cliente potencial o ID de pedido. Cuando se produce una conversión más adelante, el ID de clic se puede recuperar mediante esa clave y añadirse al evento de conversión. Este enfoque sigue requiriendo un identificador estable que conecte el clic original con el evento posterior, pero permite que los datos de atribución perduren en situaciones en las que el almacenamiento en el navegador ya no está disponible.
7. Almacenamiento general de datos
Por último, Data Store es útil en casi cualquier caso en el que necesite almacenar datos de forma temporal o a largo plazo para utilizarlos después. Es más confiable y escalable que las cookies o el almacenamiento local. Todo lo que necesita es una clave para escribir y recuperar los datos, como el correo electrónico de un usuario, un ID o un token de sesión.
- Cree documentos y colecciones para albergar múltiples archivos.
- Busque y filtre utilizando condiciones.
- Establezca un TTL (tiempo de vida) para que los documentos caduquen automáticamente cuando ya no sean necesarios.
- Recupere y utilice los datos guardados en el almacén para enriquecer sus flujos de eventos de GTM del lado del servidor (por ejemplo, para atributos de usuario, parámetros personalizados o tokens).
- Utilice la API para acceder al almacén de forma programática a través de endpoints.
8. Tablas de consulta dinámicas y reglas de enrutamiento
Las tablas de consulta estándar de GTM pueden volverse difíciles de gestionar cuando las asignaciones son extensas, se actualizan con frecuencia o son operativamente delicadas. Data Store puede alojar estos conjuntos de datos en su lugar.
Por ejemplo, puede almacenar reglas de productos, clasificaciones de campañas, configuraciones regionales, asignaciones de inquilinos u otros valores de configuración. Luego puede actualizarlos a través del panel de Stape, mediante importación de CSV o por API sin volver a publicar el contenedor de sGTM cada vez que cambie un valor.
El mismo enfoque se puede utilizar para seleccionar dinámicamente destinos, cuentas, endpoints o credenciales en función de factores como la marca, la región, el inquilino, el comerciante, el tipo de evento o el estado de consentimiento.
9. Conexión de visitantes anónimos con clientes conocidos
Data Store puede ayudar a conectar la actividad anónima de un usuario con su identidad y acciones previas una vez que se da a conocer. Esto también hace que el seguimiento de clientes nuevos y recurrentes sea más confiable.
Por ejemplo, un visitante puede navegar por su sitio web antes de iniciar sesión o enviar un formulario. Usted puede almacenar la relación entre su identificador anónimo de navegador o sesión y su identificador de cliente. Una vez que el usuario pasa a ser conocido, los eventos futuros pueden utilizar esa relación para recuperar atributos de identidad aprobados y mantener la continuidad en sesiones que antes eran anónimas.
10. Aplicación de estados de consentimiento a eventos de backend
La información de consentimiento suele estar disponible en el navegador, pero falta cuando un evento proviene de un CRM, un webhook, un sistema offline u otra fuente de backend. Data Store puede conservar el estado de consentimiento del usuario junto con metadatos como su origen, marca de tiempo o versión de la política.
Cuando llega un evento de backend posterior, se puede recuperar el estado de consentimiento almacenado antes de decidir qué destinos y parámetros están permitidos. Esto ayuda a aplicar reglas de consentimiento coherentes a los eventos que no provienen del navegador.
11. Captura de datos de solicitudes para depuración dirigida
En algunos casos, los registros estándar no conservan la carga útil de la solicitud ni los campos específicos necesarios para investigar un problema de seguimiento. Data Store puede almacenar temporalmente datos de solicitudes seleccionadas en una colección dedicada para la depuración.
Este enfoque debe utilizarse con precaución: aplique activadores específicos, TTL cortos, minimización de datos y filtrado de PII. Almacenar cada solicitud puede generar riesgos de privacidad innecesarios y consumir rápidamente los límites de escritura de la base de datos.
Conclusión
Data Store ha pasado de ser una función simple a una potente herramienta que respalda una amplia gama de casos de uso de datos y seguimiento. Con ella, puede configurar el seguimiento multidominio, corregir transacciones duplicadas, crear un CDP ligero o simplemente almacenar datos para su uso posterior.
Dado que está integrada directamente en la plataforma de Stape, no es necesario configurar ni mantener una base de datos externa. Puede comenzar a guardar y recuperar datos directamente dentro de su contenedor de GTM del servidor. Data Store puede sustituir herramientas como Firestore manteniendo todo bajo un mismo techo.
¿Desea empezar del lado del servidor?
Probar gratis
Comentarios